⚡ L’essentiel
Microsoft a obtenu le 25 août 2026 un brevet décrivant un système de réponses IA sélectives pour Bing. Le moteur calcule un score de complexité pour chaque requête : seules les questions nécessitant une synthèse de plusieurs sources déclenchent une réponse générative, tandis que les recherches simples (comme « youtube ») affichent des résultats classiques. Cette approche hybride optimise les coûts de calcul tout en préservant l’expérience utilisateur, mais elle transforme profondément les stratégies SEO.
Un brevet qui révèle les coulisses de la recherche générative
Le 12 octobre 2026, l’expert SEO Ian Sorin a attiré l’attention sur LinkedIn sur un document technique publié discrètement cet été par Microsoft. Le brevet US 12,717,798 B2, intitulé « Generative search results documents based on enhanced search results using generative artificial intelligence (AI) models », décrit le fonctionnement d’un système de réponses génératives pour Bing, comparable aux AI Overview de Google.
Déposé le 28 février 2025 et accordé le 25 août 2026, ce brevet de 20 revendications et 13 planches de dessins appartient à Microsoft Technology Licensing. Selon Ian Sorin, le système diffère peu dans les grandes lignes de celui de Google, mais plusieurs mécanismes spécifiques méritent l’attention des professionnels du référencement.
Comme tout brevet, ce document décrit un système possible et ne garantit pas que chaque mécanisme soit implémenté tel quel dans le moteur en production. Il offre néanmoins un aperçu précieux de la direction stratégique de Microsoft dans la course à l’IA générative.
Le score de complexité : un filtre économique autant que technique
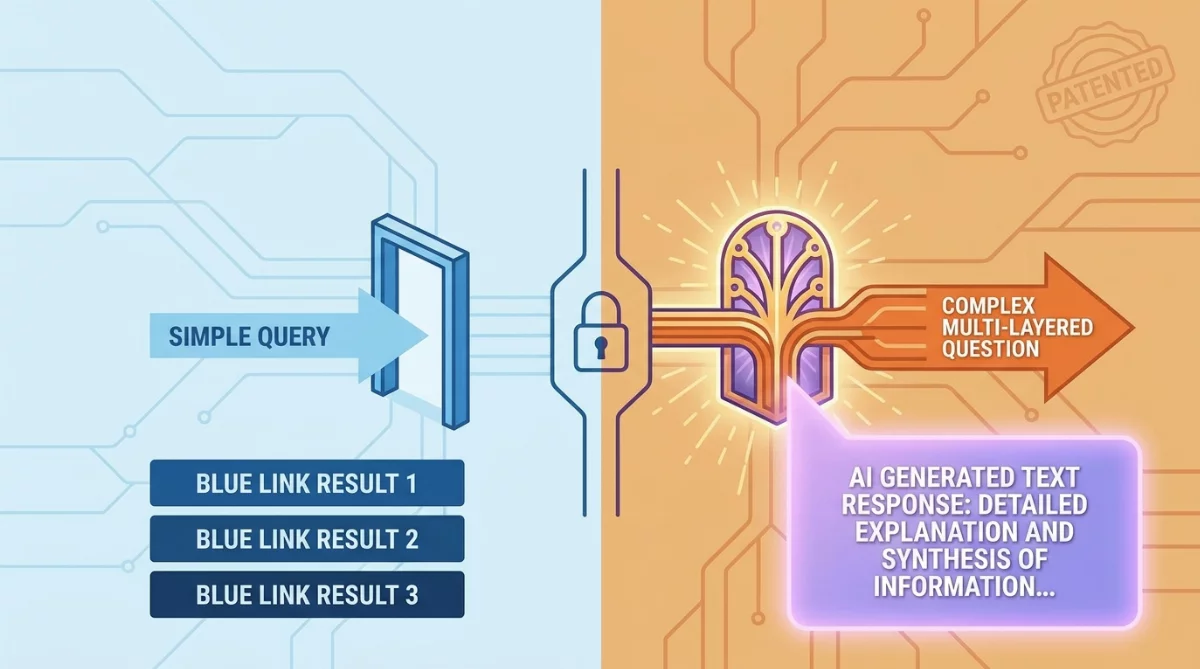
L’innovation centrale du brevet réside dans son approche sélective. Contrairement à une génération systématique de réponses IA pour toutes les recherches, Bing évalue d’abord la complexité de chaque requête via un score calculé automatiquement.
Une recherche simple comme « youtube » ou « météo Paris » ne déclenchera pas de document génératif. L’utilisateur obtiendra des résultats classiques, car il cherche simplement à accéder à un site connu ou à une information factuelle directe. En revanche, une question comme « Comment l’intelligence artificielle transforme-t-elle l’éducation ? » franchira le seuil de complexité et bénéficiera d’une réponse synthétique compilant plusieurs sources.
Cette stratégie révèle une vérité économique rarement discutée : générer des réponses IA pour 100% des recherches serait prohibitif en coûts de calcul. Selon des analyses du secteur, l’inférence de modèles de langage à grande échelle peut coûter plusieurs fois plus cher qu’une recherche traditionnelle. Microsoft adopte donc une approche pragmatique, réservant ses ressources aux requêtes où l’IA apporte une vraie valeur ajoutée.
Le « query fan-out » : un SEO multidimensionnel
Une fois le seuil de complexité franchi, le système déploie une technique sophistiquée appelée « query fan-out » (déclinaison en recherches alternatives). La question initiale de l’utilisateur est décomposée en plusieurs sous-requêtes plus spécifiques.
Exemple concret : si vous cherchez « Quelle voiture électrique acheter en 2026 ? », le système pourrait générer automatiquement des sous-requêtes comme « autonomie voitures électriques 2026 », « prix voitures électriques comparatif », « fiabilité Tesla vs Renault », etc.
Pour chaque sous-requête, Bing récupère des résultats de recherche classiques. C’est alors qu’intervient un élément crucial révélé par le brevet : un « petit modèle d’IA » note et classe ces résultats. Ce modèle léger et rapide (probablement pour des raisons de coût) filtre les sources avant qu’un modèle plus puissant ne rédige la réponse finale.
Cette architecture transforme fondamentalement la nature du référencement. Il ne suffit plus d’être pertinent pour LA requête de l’utilisateur : il faut être pertinent pour les multiples sous-requêtes générées automatiquement par le système. Les créateurs de contenu doivent désormais penser en « graphe de connaissances » plutôt qu’en « article unique ».
Le système de cache : une nouvelle forme d’inertie informationnelle
Selon le brevet, une fois générée, une réponse IA peut être réutilisée tant que les résultats web ne changent pas au-delà d’un certain seuil. Ce mécanisme de cache optimise les ressources, mais crée un nouveau type de « fraîcheur » du contenu.
Contrairement au référencement traditionnel où mettre à jour votre contenu peut rapidement améliorer votre positionnement, ici votre visibilité dépend de l’évolution de l’ensemble des résultats sur le sujet. Un site pourrait publier un excellent nouvel article sans apparaître dans la réponse IA pendant des jours ou des semaines si le cache n’est pas invalidé.
Inversement, un contenu ancien pourrait rester cité longtemps même après avoir perdu en pertinence. Cette inertie crée de nouveaux défis pour les professionnels cherchant à maximiser leur visibilité dans un écosystème où la fraîcheur n’est plus seulement une question de date de publication.
Implications pour les professionnels du SEO
Pour les référenceurs et les éditeurs de sites web, ce brevet soulève des questions stratégiques majeures. D’après le document, la sélection se joue au niveau du lien et des sous-requêtes. Concrètement, votre contenu peut être utilisé pour générer une réponse sans que l’utilisateur ne visite jamais votre site.
Les requêtes simples navigationnelles (noms de marques, sites connus) restent épargnées, préservant ce segment de trafic. Mais les requêtes complexes à forte valeur ajoutée – guides d’achat, tutoriels approfondis, analyses comparatives – risquent de générer des « zero-click searches » : l’utilisateur obtient sa réponse directement, même si vous êtes cité comme source.
Le manque de transparence sur les critères de notation des sources par le « petit modèle d’IA » complique l’optimisation. Contrairement aux algorithmes de classement traditionnels dont les grandes lignes sont documentées, ce système de notation reste une boîte noire. Les professionnels devront procéder par tests et reverse engineering pour comprendre les facteurs de sélection.
Une stratégie hybride face à Google
L’approche de Microsoft contraste avec celle de Google, qui semble déployer ses AI Overview de manière plus agressive. En adoptant une stratégie sélective, Microsoft reconnaît implicitement que l’IA générative n’est pas pertinente pour toutes les requêtes.
Cette prudence pourrait s’avérer judicieuse. Les réponses génératives posent plusieurs défis non résolus : risque d’hallucinations (informations inventées par l’IA), questions de droit d’auteur sur l’utilisation du contenu source, impact sur le modèle publicitaire traditionnel des moteurs, et concentration du pouvoir informationnel.
Le brevet mentionne un bouton « Deep search » à côté du champ de recherche, suggérant que l’utilisateur pourrait aussi déclencher manuellement une recherche approfondie avec IA. Cette option donne un contrôle supplémentaire à l’utilisateur et pourrait servir de transition progressive vers une adoption plus large.
Questions ouvertes et perspectives d’évolution
Plusieurs incertitudes demeurent. Le brevet ne précise pas les critères exacts du score de complexité ni les seuils déclenchant la génération. L’étendue géographique du déploiement et le pourcentage d’utilisateurs ayant accès à ces fonctionnalités restent flous.
À moyen terme, plusieurs scénarios sont possibles. Microsoft pourrait déployer progressivement le système à plus d’utilisateurs, en affinant les algorithmes basés sur les retours. Une guerre des brevets avec Google pourrait ralentir l’innovation. L’émergence d’accords de licensing entre moteurs et éditeurs premium pourrait créer un écosystème à deux vitesses. Enfin, les régulateurs européens ou américains pourraient imposer des règles sur la transparence des sources et la rémunération des créateurs.
La question de la monétisation reste centrale : comment Microsoft compte-t-il générer des revenus publicitaires si les utilisateurs cliquent moins sur les résultats traditionnels ? Les créateurs de contenu seront-ils rémunérés pour l’utilisation de leur travail dans les synthèses IA, comme le réclament certains éditeurs dans leurs contentieux avec OpenAI ?
Conclusion : une révolution progressive plutôt qu’un big bang
Ce brevet révèle que la « révolution IA » dans la recherche sera probablement plus progressive et hybride qu’annoncé. Les moteurs ne remplaceront pas tous les résultats classiques du jour au lendemain, mais créeront une expérience à deux vitesses selon la nature de la requête.
Pour les professionnels du SEO, cela signifie que les fondamentaux du référencement restent cruciaux. Mais ils doivent désormais être complétés par de nouvelles compétences : structurer le contenu pour le query fan-out, optimiser pour la sélection par les modèles d’IA, et diversifier les sources de trafic pour réduire la dépendance à un seul canal.
La vraie question n’est plus de savoir si l’IA transformera la recherche, mais comment naviguer cette transition tout en préservant un écosystème informationnel sain, où les créateurs de contenu sont valorisés et les utilisateurs reçoivent des informations fiables. Le brevet de Microsoft offre un aperçu de cette transition, mais l’histoire reste à écrire.
About The Author