⚡ L’essentiel
Google empoisonne intentionnellement les résultats de recherche envoyés aux outils de tracking SEO depuis septembre 2026. En moyenne 8% des données sont faussées (jusqu’à 27% en pic), rendant les rapports de positionnement d’Ahrefs, SEMrush et consorts partiellement inexploitables. La théorie : protéger ses données contre l’entraînement des IA concurrentes comme ChatGPT, avec l’industrie SEO comme dommage collatéral.
Une bombe à retardement pour l’industrie du SEO
Imaginez un thermomètre qui afficherait volontairement de fausses températures aux médecins. C’est exactement ce que fait Google depuis septembre 2026 avec les outils professionnels de référencement. Selon l’expert SEO Brodie Clark, qui a révélé l’affaire le 16 octobre, le géant de Mountain View sert des « SERPs empoisonnés » — des résultats de recherche délibérément falsifiés — aux rank trackers utilisés quotidiennement par des milliers d’agences et professionnels du marketing digital.
Les chiffres donnent le vertige : d’après les données de Nozzle, plateforme d’analyse ayant scruté des millions de recherches, 8% des résultats sont en moyenne corrompus, avec des pics atteignant 27% durant certaines périodes. Pour une industrie du SEO estimée à plus de 80 milliards de dollars et reposant entièrement sur la fiabilité des mesures de positionnement, c’est un tremblement de terre.
Qu’est-ce qu’un SERP empoisonné exactement ?
Un SERP empoisonné ressemble en surface à une page de résultats normale. Mais en y regardant de près, les URLs affichées n’ont rien à voir avec ce que voient les vrais utilisateurs. Prenons un exemple concret : un outil de tracking interroge Google pour la requête « serplens » en Australie. Le 10 octobre 2026, il reçoit un ensemble de résultats. Le 15 octobre, pour la même requête, les résultats sont radicalement différents — avec des sites non pertinents apparaissant soudainement dans le top 10.
Le problème ? Ces variations ne reflètent pas la réalité. Les utilisateurs humains, eux, voient des résultats cohérents et stables. Seuls les outils automatisés reçoivent ces données divergentes. Résultat : un professionnel du SEO pourrait croire que son site a chuté de la position 3 à la position 15, alors qu’en réalité, rien n’a bougé.
Pourquoi Google sabote-t-il ses propres données ?
La théorie dominante pointe vers la guerre de l’IA générative. Google chercherait à protéger ses précieuses données de recherche contre les modèles de langage concurrents comme ChatGPT, Claude ou Gemini d’autres acteurs. Ces LLM ont potentiellement besoin de vastes quantités de données pour leur entraînement, et les résultats de recherche Google constituent une mine d’or.
En empoisonnant les résultats accessibles via scraping ou API, Google rendrait ces données inutilisables pour l’entraînement d’IA. Le problème ? Les outils de tracking SEO sont pris entre deux feux, victimes collatérales d’une bataille qui ne les concerne pas directement. Des plateformes comme DataForSEO (fournisseur d’API) et des outils comme Ahrefs voient leurs datasets massivement corrompus.
Certains observateurs suggèrent une motivation plus sombre : Google pourrait aussi vouloir réduire la transparence de son algorithme, rendant plus difficile pour les professionnels du SEO de décrypter ses évolutions.
Une contamination mondiale aux impacts variables
Le phénomène n’est pas uniforme géographiquement. Les données de Nozzle révèlent des disparités frappantes entre pays : la Nouvelle-Zélande affiche un taux d’empoisonnement de 13,8%, tandis que le Royaume-Uni n’est touché qu’à hauteur de 3%. Cette variation suggère soit un déploiement progressif, soit des tests A/B par Google pour calibrer le niveau optimal d’empoisonnement.
Les marchés moins scrutés juridiquement, comme la Nouvelle-Zélande, pourraient servir de terrains d’expérimentation avant un déploiement dans les zones à risque réglementaire élevé comme l’Union européenne ou les États-Unis. Une stratégie classique des grandes plateformes pour tester les limites du tolérable.
Comment détecter un SERP empoisonné ?
Face à cette nouvelle réalité, les professionnels ne sont pas totalement démunis. Brodie Clark recommande l’utilisation d’outils de comparaison de SERP comme SERP Lens. Le principe : comparer les résultats de recherche entre différentes dates pour identifier les variations anormales.
Une chute de position légitime se manifeste généralement par une évolution progressive et cohérente. Un SERP empoisonné, lui, montre des changements drastiques et illogiques : des URLs totalement non pertinentes apparaissant soudainement, des sites inconnus surgissant dans le top 10, puis disparaissant quelques jours plus tard.
La solution technique proposée par Clark combine SERP Lens MCP avec Claude Desktop et Notion pour générer des rapports de positionnement automatisés mais fiables, contournant apparemment les mécanismes de détection de Google. Ces rapports couvrent par défaut la première page de résultats, avec possibilité d’étendre à la page 2.
Implications pour les professionnels du référencement
Pour les agences SEO et consultants, les conséquences sont immédiates et potentiellement dévastatrices :
- Crédibilité en jeu : annoncer à un client une chute de positionnement qui n’existe pas érode la confiance.
- Décisions stratégiques faussées : investir dans l’optimisation d’une page basée sur des données erronées gaspille temps et budget.
- Reporting à revoir : tous les rapports depuis septembre 2026 sont potentiellement contaminés et nécessitent une vérification.
- ROI des outils questionné : payer des milliers d’euros annuels pour des données partiellement fausses devient difficilement justifiable.
Les professionnels avertis adoptent désormais une approche multi-sources : croiser systématiquement les données des rank trackers avec Google Search Console (qui reste fiable car fourni directement par Google), des vérifications manuelles pour les mots-clés critiques, et des outils de comparaison de SERP.
Vers un SEO « post-positions » ?
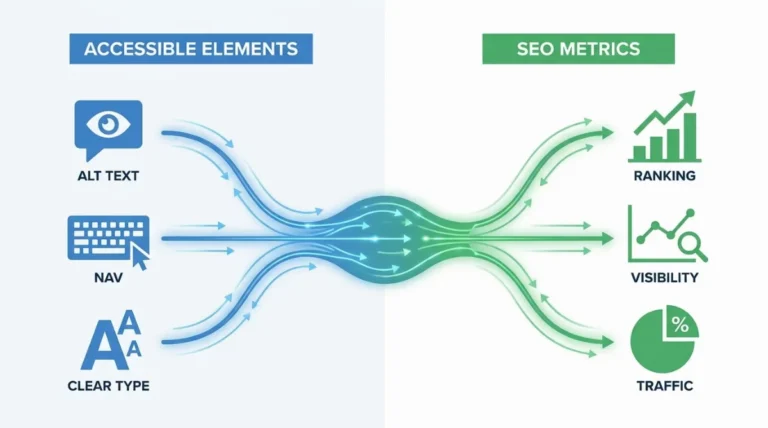
Paradoxalement, cette crise pourrait accélérer une évolution déjà en cours : l’abandon progressif de l’obsession des positions au profit de métriques plus significatives. Trafic qualifié, taux de conversion, visibilité de marque, autorité thématique — ces indicateurs reflètent mieux la performance réelle qu’une position fluctuante dans un classement.
Certains experts y voient une opportunité de maturité pour l’industrie. Plutôt que de fixer des KPI sur « être en position 3 pour tel mot-clé », les stratégies SEO pourraient se recentrer sur la création de valeur réelle pour les utilisateurs, mesurée par des métriques business concrètes.
Questions juridiques et antitrust
Au-delà des implications techniques, cette affaire soulève des questions légales majeures. Un acteur en position dominante (Google détient 92% du marché de la recherche) peut-il délibérément fausser les données pour empêcher la surveillance de son service ?
Dans l’Union européenne, où Google fait déjà face à plusieurs procédures antitrust, cette pratique pourrait être qualifiée d’abus de position dominante. Le Digital Markets Act, entré en vigueur en 2023, impose aux « gatekeepers » comme Google des obligations de transparence et d’interopérabilité. Empoisonner les données pourrait violer ces principes.
Aux États-Unis, où le Department of Justice poursuit déjà Google pour monopole illégal, cette révélation pourrait alimenter le dossier à charge. Des class actions collectives de l’industrie du SEO ne sont pas à exclure, réclamant des dommages et intérêts pour les préjudices commerciaux subis.
Réactions et solutions de l’industrie
À l’heure actuelle, les grands acteurs comme Ahrefs, SEMrush ou Moz n’ont pas communiqué officiellement sur le sujet. Ce silence est en soi révélateur : reconnaître publiquement que leurs données sont corrompues pourrait déclencher une vague de résiliations d’abonnements.
En coulisses, ces entreprises travaillent probablement sur des solutions de contournement : utilisation de proxies résidentiels pour simuler des recherches humaines, diversification des sources de données, intégration d’algorithmes de détection d’anomalies, ou même passage à des méthodologies entièrement différentes basées sur l’analyse de trafic réel plutôt que de positions.
Pour les professionnels, les recommandations actuelles incluent :
- Vérification croisée systématique : ne jamais se fier à une seule source de données
- Priorisation de Google Search Console : seule source véritablement fiable car directement fournie par Google
- Tests manuels réguliers : vérifier personnellement les positions pour les mots-clés stratégiques
- Adoption d’outils de comparaison : SERP Lens ou équivalents pour détecter les anomalies
- Réorientation vers des métriques business : trafic, conversions, revenus plutôt que positions brutes
Scénarios pour les prochains mois
Plusieurs futurs sont possibles :
Scénario 1 – L’escalade : Google intensifie l’empoisonnement jusqu’à rendre le tracking traditionnel totalement impossible (50%+ de données corrompues). L’industrie bascule vers des méthodologies entièrement nouvelles, avec une concentration du pouvoir informationnel encore accrue chez Google via Search Console.
Scénario 2 – L’intervention réglementaire : Les autorités antitrust (Commission européenne, DoJ américain) considèrent cette pratique comme un abus et forcent Google à cesser. Retour à la normale mais avec surveillance réglementaire renforcée et possibles amendes.
Scénario 3 – La course technologique : Les outils de tracking développent des solutions sophistiquées (IA, méthodes distribuées, simulation parfaite de comportements humains) contournant durablement les détections de Google. Guerre d’usure technique entre les deux camps.
Scénario 4 – La normalisation : L’industrie accepte cette nouvelle réalité comme un coût d’exploitation. Les outils intègrent des coefficients de correction statistiques, de nouveaux standards émergent, et le marché s’adapte avec une prime pour les solutions les plus fiables.
Ce que révèle cette affaire
Au-delà du cas spécifique du SEO, cette situation expose des dynamiques structurelles inquiétantes de l’économie numérique :
Dépendance systémique : Une industrie entière de 80+ milliards repose sur l’accès aux données d’un acteur unique qui peut unilatéralement changer les règles. C’est un risque systémique comparable à la dépendance des développeurs iOS à Apple ou des commerçants à Amazon.
Fermeture du web : Cette pratique s’inscrit dans une tendance plus large de « walled gardens » — les grandes plateformes érigent des barrières toujours plus hautes contre le scraping et l’extraction de données, fragmentant le web ouvert.
Pouvoir informationnel : En contrôlant à la fois les données ET leur accessibilité, Google concentre un pouvoir démesuré. Si cette « weaponisation » des données fait jurisprudence, d’autres plateformes (Meta, Amazon, LinkedIn) pourraient suivre.
Efficacité réelle douteuse : Ironiquement, cette mesure anti-LLM pourrait être contournée par les acteurs sophistiqués (OpenAI, Anthropic) disposant de ressources massives, tout en pénalisant principalement les PME et professionnels du SEO.
Conclusion : une industrie à la croisée des chemins
L’empoisonnement des SERPs par Google marque potentiellement un tournant historique pour l’industrie du référencement. Soit cette pratique force une évolution salutaire vers des métriques plus significatives et un SEO plus mature, soit elle inaugure une ère d’opacité croissante où seuls les acteurs disposant d’un accès privilégié aux données (via des partenariats avec Google) peuvent opérer efficacement.
Pour les professionnels, l’urgence est triple : auditer immédiatement tous les rapports depuis septembre 2026, diversifier les sources de données et méthodologies, et anticiper un environnement où la transparence algorithmique continuera de se réduire.
Une question demeure, lourde d’implications : si Google peut falsifier ses données sans conséquences, quelle plateforme dominante sera la prochaine à weaponiser l’information contre ceux qui tentent de la mesurer ?
About The Author